多站点 Zabbix 集中监控平台: 9 个生产站点,一个仪表盘
一套定制监控平台:把 9 个生产站点(横跨三个 Zabbix 版本)聚合进一个仪表盘,防火墙日志汇入 ClickHouse 实现上亿条记录的秒级检索,告警卡片推送到企业 IM 并在故障恢复后自动变绿。
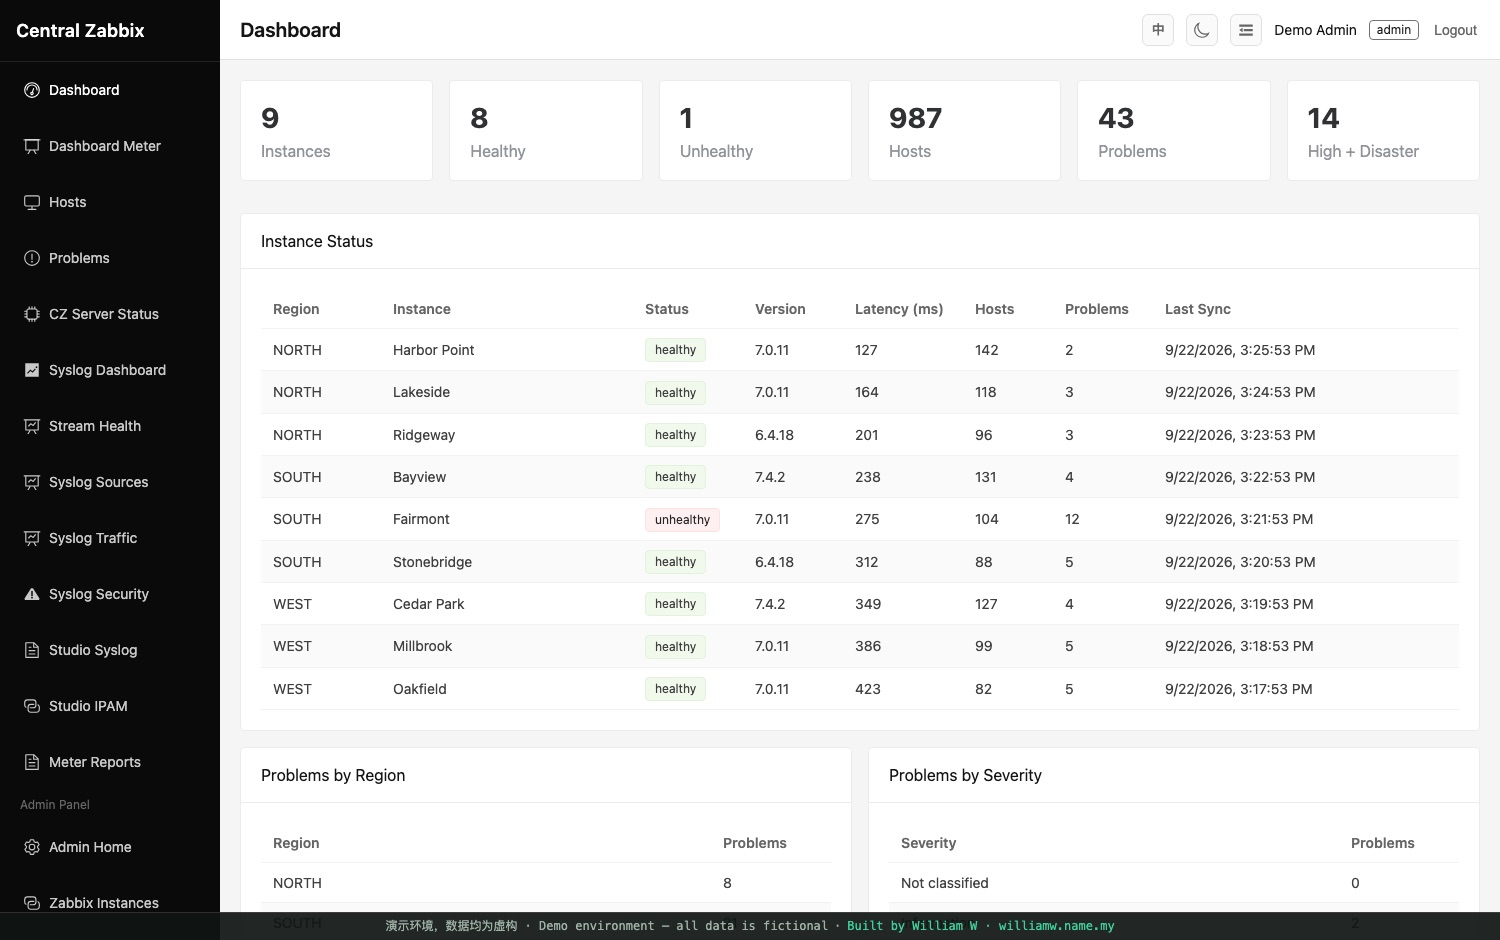
FairmontSOUTH
12 个问题
- 主机
- 104
- 延迟
- 275 ms
异常演示数据
客户面对的问题
运维团队管理着分布在各站点的 9 套独立 Zabbix:三个不同版本、9 个登录入口、9 个仪表盘。看全局状态要逐个登录;防火墙日志留在设备上,查一次又慢又痛苦;告警是一条条纯文本,分不清哪些已经恢复。
交付了什么
- 一个仪表盘聚合全部 9 个站点的主机、告警与健康状态,站点级故障隔离,API 入口自动主备切换
- 兼容层抹平 Zabbix 6.4 / 7.0 / 7.4 的 API 差异,各站点按自己的节奏升级
- 防火墙 Syslog 管道汇入 ClickHouse:上亿条记录秒级检索,带流量 / UTM / 事件分析
- 企业 IM 里的告警卡片会自我更新(故障恢复自动变绿),另有定时图表报告推送
- Zabbix 仪表盘复刻:6 个月交互式历史 + 约 3.5 年小时级归档
- 只读 AI 助手:在聊天里问「A 站点哪些主机挂了?」直接得到答案和数据卡片
技术栈
- Vue 3
- FastAPI
- PostgreSQL
- ClickHouse
- Docker
- AI / MCP
带来的改变
- 日常运维从 9 次登录变成一个屏幕,跨站点健康状态一眼可见
- 过去要 SSH 上设备翻的防火墙日志,现在是一个搜索框、亚秒级出结果
- 已恢复的告警自己标绿,团队不再反复确认早已恢复的事件
- 不懂 Zabbix 的同事也能通过 AI 助手拿到监控答案
常见问题
我们已有的 Zabbix 环境能直接接入吗?
可以,这正是它的设计初衷。平台通过 API 连接你现有的 Zabbix(6.4 到 7.4 都已适配),现有监控不需要重建或迁移。
我们用 WhatsApp / Telegram 而不是飞书,告警能推过去吗?
告警管道不绑定渠道:已交付版本推送到飞书,加 WhatsApp(官方 API)、Telegram 或 Teams 属于集成阶段的工作,不需要重新设计。
做一套这样的监控平台要多久?
第一个能用的阶段(多站点聚合仪表盘 + IM 告警)是几周的工作量。日志分析、仪表盘复刻和 AI 助手都是在同一平台上按里程碑后续加上的。